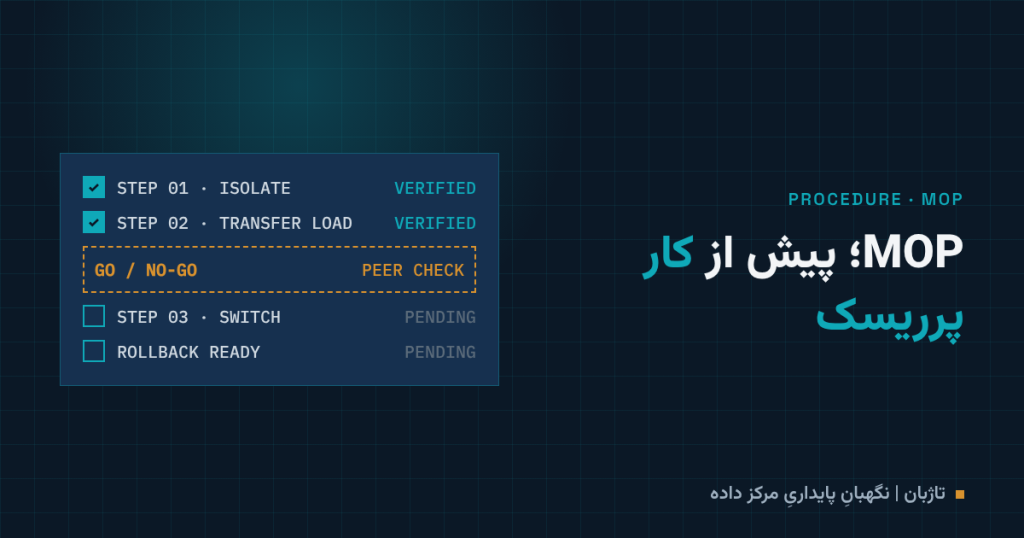
بیشتر توقفهای برنامهریزینشدهٔ مرکز داده از یک خرابی بزرگ شروع نمیشوند. از یک کار نگهداری معمولی شروع میشوند که کسی آن را «ساده» فرض کرده است: جابهجایی یک کلید، تست یک UPS، قطع یک مسیر برای تعویض قطعه. MOP (Method of Procedure) برای همین ساخته شده است: کار پرریسک را از حافظهٔ یک نفر بیرون میآورد و به یک سند قابل بررسی تبدیل میکند.
MOP با SOP چه فرقی دارد؟
SOP برای کار عادی و تکراری است، مثل بازدید روزانه یا تحویل شیفت. MOP برای کاری است که اگر اشتباه شود، بار حیاتی را تهدید میکند. در MOP هر گام، نتیجهٔ مورد انتظار و شرط ادامه دادن دارد. EOP هم برای وقتی است که اتفاقی افتاده و باید سریع و بدون تصمیمگیری از صفر عمل شود.
اجزای یک MOP خوب
- سربرگ: شناسهٔ سند، نسخه، سطح ریسک (حیاتی، عمده، کوچک)، زمان تخمینی اجرا، تجهیزات حفاظت فردی و افراد لازم.
- پیشنیازها: ابزار کالیبره، قطعهٔ یدکی در سایت، تأییدیهٔ کمیتهٔ تغییر، اعلام به ذینفعان و نبودن کار دیگری که با این کار تداخل دارد.
- جدول اجرا: هر ردیف یک گام است با چهار ستون: شمارهٔ گام، دستور دقیق (فعل امری)، وضعیت مورد انتظار پس از گام، و جای امضای اجراکننده و بازبین.
- نقاط ادامه یا توقف: در نقاط مشخص، قبل از ادامه باید بهصراحت پرسیده شود «ادامه بدهیم یا برگردیم؟» و جواب ثبت شود.
- پروتکل بازگشت: معیار لغو کار و گامهای برگرداندن مرکز داده به وضعیت امن، پیش از شروع نوشته شده باشد، نه وسط بحران.
شیوهٔ اجرا: پرسش و پاسخ
در هوانوردی، خلبان و کمکخلبان چکلیست را با «پرسش و پاسخ» میخوانند: یک نفر گام را میخواند، نفر دوم وضعیت را نگاه میکند و تأیید میکند. همین روش برای MOP مناسب است. اجراکننده نمیگوید «انجام شد»؛ بازبین جداگانه وضعیت را میبیند و امضا میکند. هدف بیاعتمادی به همکار نیست؛ هدف این است که خطای یک نفر به خطای سیستم تبدیل نشود.
چند خطای رایج
- نوشتن MOP بعد از انجام کار، فقط برای پرونده.
- گامهای کلی مثل «UPS را بررسی کنید» بهجای دستور دقیق و وضعیت قابل مشاهده.
- نداشتن معیار لغو، که باعث میشود تیم برای «تمام کردن کار» از نقطهٔ بازگشت رد شود.
- اجرا توسط یک نفر بدون بازبین.
جمعبندی
MOP مانع کار نیست؛ کار پرریسک را قابل پیشبینی میکند. اگر تیم شما هنوز کارهای حساس را از حافظه یا پیامرسان اجرا میکند، با یک کار تکراری و پرریسک شروع کنید و برای آن MOP بنویسید.